 |
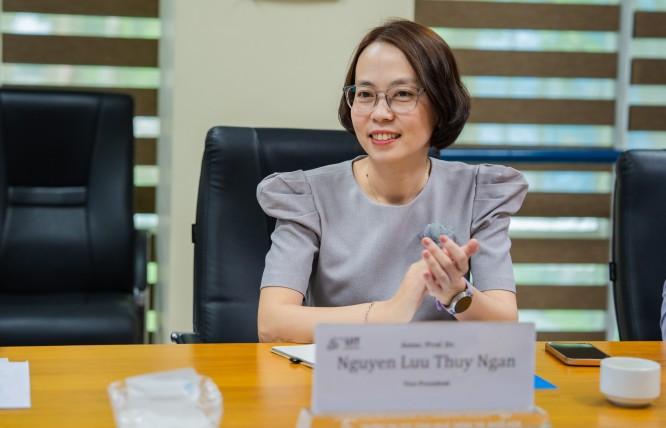
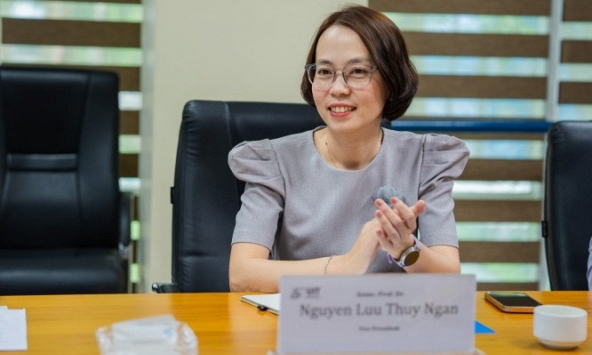
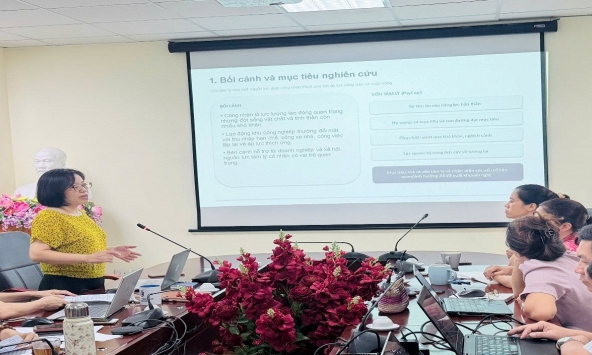
| PGS.TS. Nguyễn Lưu Thùy Ngân tại buổi làm việc giữa UIT và Rosen Group, ngày 10/11/2025. |
Một mô hình AI có thể tạo ra câu văn khá tự nhiên nhưng vẫn trả lời sai khi phải xác định một thông tin có thực sự suy ra được từ dữ kiện ban đầu hay không. Với tiếng Việt, bài toán càng khó khi nguồn dữ liệu dùng để kiểm tra những tình huống như vậy chưa phong phú như ở các ngôn ngữ lớn. Đây là một trong những hướng nghiên cứu mà PGS.TS. Nguyễn Lưu Thùy Ngân, giảng viên và Phó Hiệu trưởng Trường Đại học Công nghệ Thông tin, ĐHQG-HCM (UIT), cùng các cộng sự tại nhóm xử lý ngôn ngữ tự nhiên của trường đang theo đuổi. Bà có bằng tiến sĩ từ Đại học Tokyo và hiện là người phụ trách UIT NLP Group.
Tháng 4/2026, Expert Systems with Applications công bố công trình của Huỳnh Văn Tín, Nguyễn Văn Kiệt và PGS.TS. Nguyễn Lưu Thùy Ngân về ViANLI, một bộ dữ liệu được thiết kế để thử sức các mô hình ở bài toán suy luận ngôn ngữ tự nhiên bằng tiếng Việt. Khác với việc kiểm tra AI bằng những ví dụ đã tương đối quen thuộc, dữ liệu “đối kháng” được tạo ra nhằm chủ động đặt mô hình vào những trường hợp khó, nơi các điểm yếu về ngữ nghĩa, logic hoặc cách xử lý câu chữ dễ bộc lộ hơn.
Đặt AI vào những câu hỏi dễ khiến nó sai
Trong suy luận ngôn ngữ tự nhiên, mô hình thường được giao một câu làm tiền đề và một câu làm giả thuyết, sau đó phải xác định giả thuyết được suy ra từ tiền đề, mâu thuẫn với nó hay không đủ căn cứ để kết luận. Nhóm tác giả giới thiệu ViANLI là bộ dữ liệu suy luận ngôn ngữ tự nhiên đối kháng đầu tiên dành cho tiếng Việt. Bộ dữ liệu gồm hơn 10.000 cặp tiền đề - giả thuyết, được xây dựng theo quy trình có cả con người và máy tham gia, kèm bước kiểm tra lại dữ liệu.
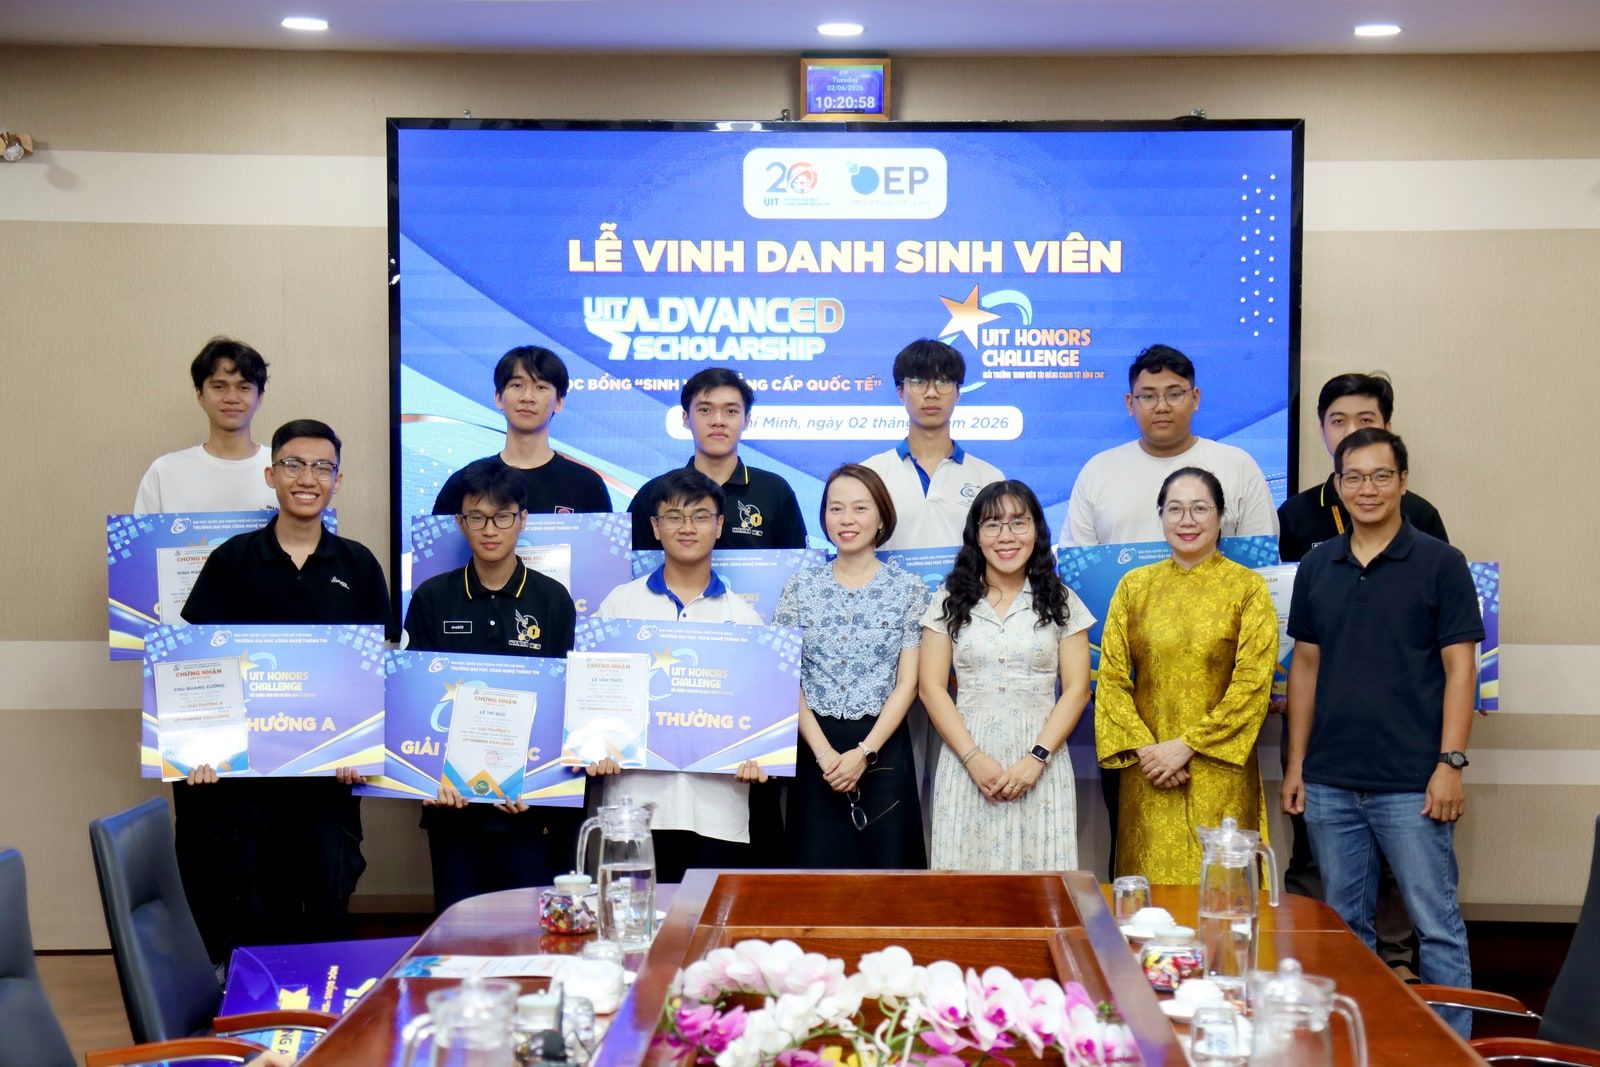 |
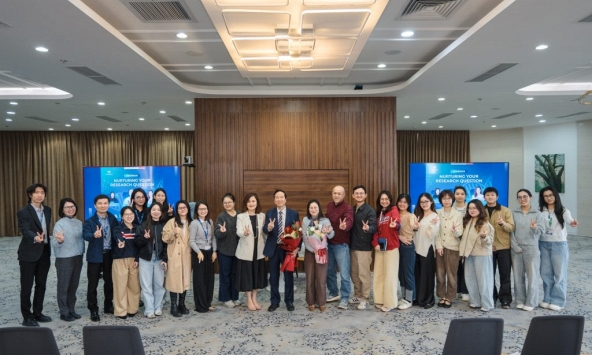
| Sinh viên và giảng viên Trường Đại học Công nghệ Thông tin, ĐHQG-HCM tại lễ vinh danh thành tích học tập, nghiên cứu khoa học tháng 6/2026. Ảnh: UIT |
Việc “làm khó” mô hình thể hiện khá rõ trong kết quả thử nghiệm. Trên ViANLI, XLM-R Large đạt độ chính xác 45,5%, trong khi mô hình NLIMoE do nhóm đề xuất đạt 47,3%. Những con số này không nên được diễn giải thành tỷ lệ AI “hiểu tiếng Việt” nói chung, bởi chúng chỉ phản ánh kết quả trên một bài kiểm tra và cấu hình thí nghiệm cụ thể. Giá trị của bộ dữ liệu nằm ở chỗ nó tạo ra một thước đo khó hơn để các nhóm nghiên cứu nhận biết mô hình đang vấp ở đâu, thay vì chỉ so sánh thành tích trên những bộ dữ liệu mà hệ thống đã xử lý tương đối tốt. Các thử nghiệm của nhóm cũng ghi nhận việc bổ sung ViANLI vào dữ liệu huấn luyện giúp cải thiện kết quả trên một số bộ dữ liệu suy luận tiếng Việt khác như ViNLI, VLSP2021-NLI và VnNewsNLI.
Đây là công trình của ba tác giả, không phải sản phẩm riêng của một cá nhân. Phân công đóng góp công bố cùng bài báo ghi nhận PGS.TS. Nguyễn Lưu Thùy Ngân tham gia xây dựng ý tưởng, phân tích, phương pháp nghiên cứu, điều tra, thẩm định kết quả, giám sát và chỉnh sửa bản thảo; Huỳnh Văn Tín và Nguyễn Văn Kiệt đảm nhiệm thêm những phần việc như xử lý dữ liệu, trực quan hóa và viết bản thảo. Cách phân chia ấy cho thấy vai trò của bà Ngân thiên về thiết kế phương pháp và dẫn dắt nghiên cứu, đồng thời tránh quy toàn bộ kết quả của nhóm cho người hướng dẫn.
ViANLI cũng không xuất hiện như một hướng đi tách rời. Trước đó, PGS.TS. Nguyễn Lưu Thùy Ngân chủ nhiệm đề tài cấp ĐHQG-HCM về mô hình học đa thể thức cho dữ liệu hình ảnh và văn bản tiếng Việt. Đề tài được nghiệm thu ngày 18/7/2025, với nhóm gồm hai PGS.TS., một TS., ba ThS. và một cử nhân. Kết quả được công bố gồm hai bộ dữ liệu ViTextVQA, ViOCRVQA cùng các phương pháp ViConsFormer, ViPhoVQA và ViTextBLIP-2 cho những bài toán hỏi đáp dựa trên hình ảnh, văn bản ngoại cảnh và tiếng Việt. Chuỗi công việc này cho thấy một trục nghiên cứu tương đối rõ: muốn đánh giá và phát triển công nghệ cho tiếng Việt, trước hết phải có dữ liệu đủ sát với đặc điểm của chính ngôn ngữ đó.
Trong bối cảnh Phụ Nữ Mới từng đề cập các hướng xử lý ngôn ngữ tự nhiên tiếng Việt, phần việc của nhóm UIT tạo ra một lát cắt khác. Thay vì nhận dạng tài liệu hay tổng hợp tiếng nói, nhóm tập trung vào các bộ dữ liệu và phép thử để xem hệ thống có suy luận, đọc hiểu hoặc xử lý những đầu vào phức tạp đến mức nào.
Từ câu thử nghiệm đến những phản hồi viết như ngoài đời
Một hướng khác của nhóm được công bố tại EACL 2026 vào tháng 3. Công trình EduPulse do Nguyễn Xuân Phúc, Nguyễn Xuân Phi, Nguyễn Vĩnh Tiệp, Đặng Văn Thìn và PGS.TS. Nguyễn Lưu Thùy Ngân thực hiện đặt AI trước một loại dữ liệu rất khác: phản hồi bằng tiếng Việt của sinh viên. Những dòng nhận xét thực tế có thể chứa tiếng lóng, “teencode”, cách viết thiếu chuẩn hoặc nhiều ý kiến đan xen, khiến một hệ thống được huấn luyện chủ yếu trên văn bản sạch dễ gặp khó khăn.
EduPulse được thiết kế cho bốn nhiệm vụ gồm phân loại cảm xúc, phân loại cảm xúc theo nhóm nội dung, phát hiện đề xuất và tóm tắt ý kiến. Nhóm không sử dụng cùng một mô hình lớn cho tất cả công việc. Các mô hình ngôn ngữ lớn được dành cho những nhiệm vụ phức tạp hoặc nhạy với nhiễu, trong khi một mô hình thần kinh nhẹ hơn xử lý phần việc cần thông lượng cao và chi phí thấp. Trong thí nghiệm được công bố, kiến trúc mô-đun kết hợp của nhóm cải thiện 7,6% hiệu quả tác vụ so với những phương pháp truyền thống mà nghiên cứu dùng để đối chiếu. Con số 7,6% chỉ nên giữ đúng phạm vi thí nghiệm của EduPulse, chưa phải bằng chứng rằng hệ thống sẽ tạo ra mức cải thiện tương tự ở mọi trường hay trên mọi loại phản hồi sinh viên.
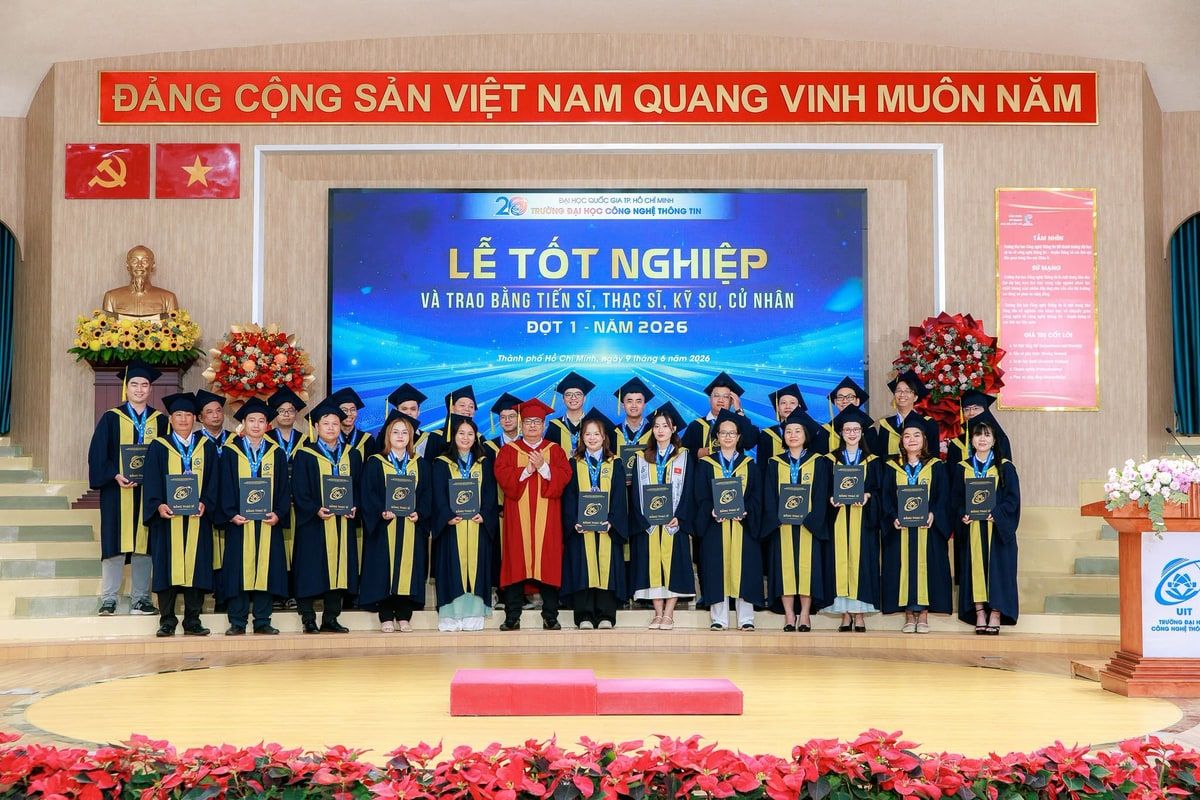 |
| Giảng viên và người học Trường Đại học Công nghệ Thông tin, ĐHQG-HCM tại lễ tốt nghiệp đợt 1 năm 2026. Nhà trường là nơi nhóm của PGS.TS. Nguyễn Lưu Thùy Ngân phát triển nhiều nghiên cứu về xử lý ngôn ngữ tự nhiên tiếng Việt. Ảnh: UIT |
Hai công trình năm 2026 tiếp cận những bài toán khác nhau nhưng gặp nhau ở một điểm: dữ liệu tiếng Việt ngoài đời không phải lúc nào cũng “ngoan”. Với ViANLI, nhóm cố tình tạo ra những trường hợp đủ khó để mô hình phải bộc lộ điểm yếu về suy luận; với EduPulse, hệ thống phải xử lý những câu chữ vốn đã lộn xộn ngay từ khi người dùng nhập vào. Thay vì lấy khả năng tạo câu trôi chảy làm bằng chứng cho mức độ thông minh của AI, hướng nghiên cứu này đưa trọng tâm trở lại phép đo: mô hình làm đúng ở đâu, sai ở đâu và cần loại dữ liệu nào để kiểm tra được những giới hạn đó.
PGS.TS. Nguyễn Lưu Thùy Ngân không đứng một mình trong các kết quả ấy. Các công trình đều có những đồng tác giả trực tiếp xây dựng dữ liệu, mô hình và thử nghiệm; nhóm UIT NLP hiện cũng gồm nhiều nhà nghiên cứu trẻ tiếp tục làm việc về suy luận, phân tích ý kiến và các bài toán ngôn ngữ. Phần đóng góp có thể xác định rõ ở bà là duy trì một hướng nghiên cứu dài hạn về dữ liệu và phương pháp cho tiếng Việt, đồng thời tham gia thiết kế và giám sát những công trình đang tìm cách kiểm tra AI bằng các tình huống khó hơn. Với một ngôn ngữ còn thiếu tài nguyên so với tiếng Anh, khả năng chỉ ra chính xác lúc nào mô hình thất bại có giá trị không kém việc tạo ra một mô hình đạt điểm cao hơn.
Dạy máy hiểu tiếng Việt để người Việt làm chủ công nghệ
Những phụ nữ Việt đang tạo nên tương lai của AI
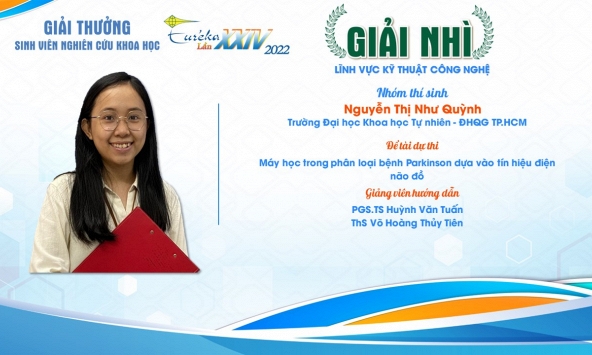
NCS Nguyễn Thị Như Quỳnh dùng máy học phân loại điện não Parkinson
Cùng chuyên mục
Những phép thử khó dành cho AI tiếng Việt
Đo sức bền tâm lý của công nhân trước áp lực công việc
ThS. Đặng Thị Thúy Yên chọn tạo hai dòng gà từ nguồn gen nội và nhập
Những túi sinh học siêu nhỏ có thể mang thuốc tới tế bào ung thư
Từ nghiên cứu dioxin đến hành trình đưa khoa học ra cộng đồng
Nhận diện sớm gen kháng thuốc cùng PGS.TS Nguyễn Thị Thu Hoài