Một hệ thống AI không tự nhiên biết thế nào là “ứng viên tốt”, “bệnh nhân có nguy cơ cao” hay “nội dung phù hợp”. Nó được huấn luyện bằng dữ liệu quá khứ, tìm kiếm những mẫu hình trong dữ liệu đó rồi sử dụng các mẫu hình này để dự đoán hoặc đưa ra kết quả mới.
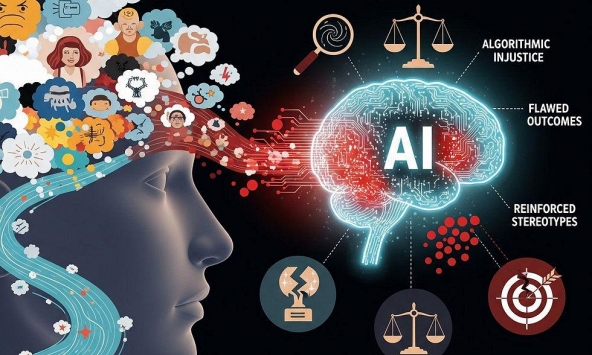
Vấn đề bắt đầu khi dữ liệu quá khứ chứa định kiến. Nếu trong một bộ hồ sơ tuyển dụng, nam giới từng được tuyển nhiều hơn phụ nữ vào vị trí quản lý, một hệ thống học máy có thể nhận diện những đặc điểm thường xuất hiện trong hồ sơ của nhóm được tuyển và coi đó là dấu hiệu của một “ứng viên phù hợp”. Nếu những đặc điểm đó vô tình gắn với nam giới, hệ thống có thể tái tạo sự mất cân bằng ấy khi đánh giá những ứng viên mới. Nói cách khác, AI không cần được lập trình để phân biệt phụ nữ mới có thể tạo ra kết quả bất lợi cho phụ nữ.
Khi dữ liệu quá khứ trở thành “thầy giáo” của AI
Một ví dụ thường được nhắc đến là hệ thống AI tuyển dụng thử nghiệm của Amazon. Theo World Economic Forum, dữ liệu dùng để huấn luyện hệ thống bao gồm hồ sơ của những người đã làm việc tại công ty và hồ sơ ứng tuyển trong khoảng 10 năm. Vì lực lượng nhân sự trong dữ liệu chủ yếu là nam giới, hệ thống bắt đầu hạ điểm những hồ sơ có những từ ngữ liên quan đến phụ nữ. Đây là một ví dụ điển hình về cách định kiến trong dữ liệu có thể được thuật toán mở rộng thành định kiến trong quyết định.
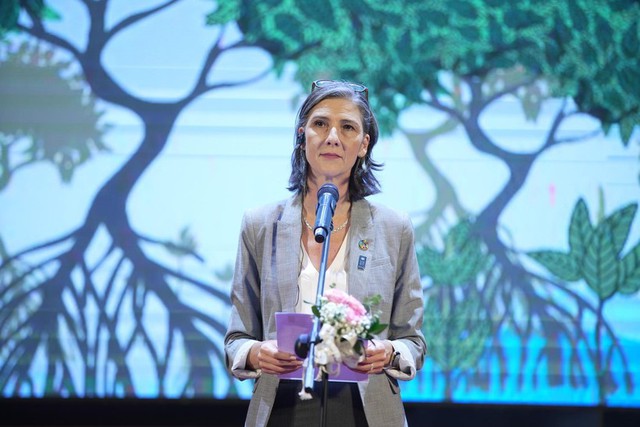
Theo PGS. TS Ramla Khalidi, Trưởng đại diện UNDP tại Việt Nam, phụ nữ cần hiện diện trong các nhóm nghiên cứu, phát triển và quản trị AI để những trải nghiệm khác nhau được phản ánh trong công nghệ.
PGS.TS Ramla Khalidi, Trưởng đại diện UNDP tại Việt Nam, cũng dẫn lại trường hợp này khi phân tích nguy cơ AI tái tạo những thiên lệch xã hội. Theo bà, một công cụ tuyển dụng được huấn luyện bằng dữ liệu lịch sử của một lực lượng lao động chủ yếu là nam giới đã hạ điểm một cách có hệ thống đối với những hồ sơ có dấu hiệu liên quan đến phụ nữ. Bài viết của UNDP Việt Nam ngày 7/3/2026 nhấn mạnh rằng nếu các nhóm đa dạng, trong đó có phụ nữ, không tham gia thực chất vào quá trình định hình chính sách AI và chuyển đổi số, những thiên lệch này có nguy cơ được “đóng” vào các hệ thống mà xã hội sử dụng hằng ngày.
Điều đáng chú ý là thuật toán không nhất thiết “có thành kiến” theo nghĩa con người thường hiểu. Nó chỉ đang tìm kiếm quy luật trong dữ liệu được cung cấp. Nhưng nếu quy luật đó phản ánh một xã hội chưa bình đẳng, kết quả của AI có thể tiếp tục duy trì sự bất bình đẳng.
Không chỉ tuyển dụng
Thiên lệch giới có thể xuất hiện ở nhiều tầng khác nhau của hệ thống AI. Trong y tế, nếu dữ liệu nghiên cứu hoặc dữ liệu bệnh nhân không phản ánh đầy đủ sự khác biệt về triệu chứng, sinh lý và nhu cầu điều trị giữa nam và nữ, mô hình AI có thể hoạt động kém hơn đối với một nhóm bệnh nhân. UN Women dẫn các nghiên cứu cho thấy những thuật toán trong y tế đã từng đánh giá sai nhu cầu điều trị, đặc biệt đối với các nhóm thiểu số.
Trong nhận diện khuôn mặt, nghiên cứu của Viện Tiêu chuẩn và Công nghệ quốc gia Mỹ (NIST) năm 2019 đánh giá 189 thuật toán của 99 nhà phát triển, sử dụng hơn 18 triệu ảnh của khoảng 8,5 triệu người. Nghiên cứu phát hiện phần lớn thuật toán được khảo sát có sự khác biệt về độ chính xác giữa các nhóm nhân khẩu học. Đáng chú ý, trong bài toán nhận diện một-nhiều, tỷ lệ nhận diện nhầm dương tính cao hơn đối với phụ nữ Mỹ gốc Phi trong tập dữ liệu được nghiên cứu.
NIST lưu ý rằng mức độ và hướng của sai lệch phụ thuộc vào từng thuật toán, nhiệm vụ và dữ liệu. Điều này cho thấy không thể nói đơn giản rằng “AI luôn thiên lệch”, nhưng cũng không thể mặc định rằng AI luôn công bằng.
Trong giáo dục, thuật toán gợi ý có thể vô tình củng cố những khuôn mẫu nghề nghiệp. Nếu dữ liệu quá khứ cho thấy nam sinh thường chọn kỹ thuật, công nghệ còn nữ sinh thường chọn các lĩnh vực xã hội, một hệ thống gợi ý học tập được thiết kế thiếu kiểm soát có thể tiếp tục đưa ra những đề xuất theo chính khuôn mẫu đó.
Trong tài chính và tín dụng, các mô hình đánh giá rủi ro có thể sử dụng nhiều biến số gián tiếp liên quan đến giới, nghề nghiệp, thu nhập, địa bàn cư trú hoặc lịch sử tài chính. Nếu dữ liệu lịch sử chứa sự bất bình đẳng, mô hình có thể biến những tương quan ấy thành tiêu chí dự đoán.
Còn trong quảng cáo và mạng xã hội, AI không chỉ quyết định người dùng nhìn thấy nội dung gì mà còn có thể quyết định họ nhìn thấy cơ hội nào. Một hệ thống phân phối việc làm, quảng cáo tài chính hay nội dung giáo dục nếu dựa quá nhiều vào hành vi trong quá khứ có thể vô tình giới hạn phạm vi thông tin mà phụ nữ được tiếp cận.
Những con số cho thấy vấn đề không nằm ngoài xã hội
Năm 2024, UNESCO công bố nghiên cứu về định kiến giới trong các mô hình ngôn ngữ lớn. Nghiên cứu kiểm tra GPT-2, GPT-3.5 và Llama 2 cho thấy các mô hình này có xu hướng tái tạo những khuôn mẫu giới. Trong một mô hình, phụ nữ được mô tả gắn với các công việc gia đình thường xuyên hơn nam giới tới 4 lần; các từ như “nhà”, “gia đình”, “con cái” thường gắn với tên phụ nữ, trong khi tên nam giới gắn với “kinh doanh”, “điều hành”, “lương” và “sự nghiệp”.
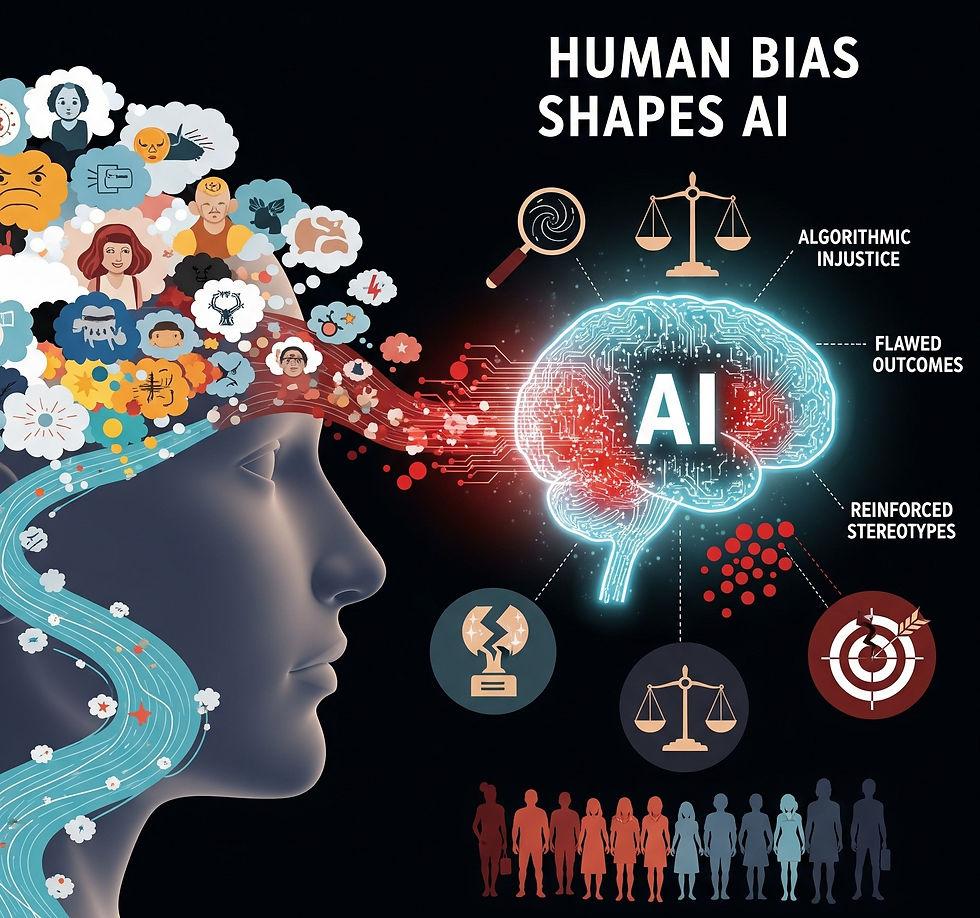
AI học từ dữ liệu của con người. Khi dữ liệu chứa định kiến, thuật toán có thể tái tạo những khuôn mẫu đó.
Một nghiên cứu khác được UN Women dẫn lại năm 2024 phân tích 133 hệ thống AI trong nhiều ngành cho thấy khoảng 44,2% có biểu hiện thiên lệch giới, trong đó 25,7% đồng thời có thiên lệch về giới và chủng tộc.
UN Women nhận định AI “phản chiếu” những định kiến đã tồn tại trong xã hội. Tổ chức này cho rằng nếu hệ thống được huấn luyện bằng dữ liệu chứa định kiến, những khuôn mẫu đó có thể đi vào sản phẩm cuối cùng. Giải pháp không chỉ nằm ở việc sửa thuật toán mà phải bắt đầu từ cách dữ liệu được thu thập, lựa chọn và đánh giá.
Việt Nam: dữ liệu về phụ nữ đã đủ?
Đây là câu hỏi cần được đặt ra khi Việt Nam bước nhanh vào kỷ nguyên AI. Không nên mặc nhiên cho rằng dữ liệu Việt Nam đang tạo ra thiên lệch giới. Nhưng cũng không thể mặc nhiên coi các bộ dữ liệu hiện có đã đại diện đầy đủ cho mọi nhóm phụ nữ Việt Nam.
Phụ nữ ở đô thị và nông thôn có cùng mức độ tiếp cận công nghệ không? Dữ liệu về phụ nữ dân tộc thiểu số có đủ để phản ánh đặc điểm ngôn ngữ, sinh kế và điều kiện tiếp cận dịch vụ của họ? Dữ liệu về phụ nữ khuyết tật có được thu thập đầy đủ? Những khác biệt về tuổi, nghề nghiệp, thu nhập, địa bàn cư trú và trách nhiệm chăm sóc gia đình có được tính đến khi xây dựng các hệ thống AI?
Đây không chỉ là câu chuyện của dữ liệu thống kê. Nó quyết định AI “nhìn thấy” ai và “không nhìn thấy” ai.
UN Women trong Gender Data Outlook 2024 nhấn mạnh rằng dữ liệu giới là công cụ quan trọng để thúc đẩy bình đẳng giới, nhưng nhiều hệ thống thống kê vẫn cần được đầu tư để cải thiện việc sản xuất, chia sẻ và sử dụng dữ liệu giới.
Tại Việt Nam, Đánh giá toàn cảnh AI (AILA) do UNDP Việt Nam phối hợp thực hiện và công bố năm 2025 cho thấy một số khoảng trống liên quan đến khả năng tiếp cận dữ liệu và các cơ chế bảo vệ. Báo cáo đồng thời nhấn mạnh rằng tính bao trùm cần được đưa ngay vào quá trình thiết kế hệ thống AI và xây dựng chính sách.
UNDP Việt Nam cũng cho biết phụ nữ hiện chiếm khoảng 37% lực lượng trong giáo dục STEM và lực lượng khoa học, công nghệ, cao hơn mức toàn cầu chỉ dưới 30%. Tuy nhiên, nghiên cứu năm 2025 của UNDP về phụ nữ trong vai trò lãnh đạo khoa học, công nghệ, đổi mới sáng tạo và chuyển đổi số cho thấy phụ nữ vẫn chưa hiện diện tương xứng ở các vị trí ra quyết định.
Điều này tạo ra một nghịch lý: phụ nữ có thể là người sử dụng AI, người chịu tác động từ AI, nhưng lại chưa có tỷ lệ tương xứng trong nhóm quyết định AI được thiết kế và quản trị như thế nào.
Muốn AI công bằng, phụ nữ phải có mặt trong dữ liệu và trong phòng thiết kế
Đây là câu hỏi quan trọng hơn cả việc AI có “thông minh” đến đâu. Một thuật toán có thể đưa ra kết quả nhanh hơn con người, nhưng tốc độ không đồng nghĩa với công bằng. Khi AI tham gia tuyển dụng, xét tín dụng, cung cấp dịch vụ công hay hỗ trợ chẩn đoán, cần có cơ chế để con người kiểm tra dữ liệu, đánh giá kết quả và can thiệp khi phát hiện sai lệch.
UNDP Việt Nam trong các khuyến nghị về AI năm 2025 đề xuất tăng cường đánh giá tác động, giám sát, minh bạch, công bằng và bảo vệ quyền riêng tư khi triển khai AI trong khu vực công.
Việt Nam cũng đã bước sang một giai đoạn pháp lý mới. Luật Trí tuệ nhân tạo số 134/2025/QH15, do Quốc hội ban hành ngày 10/12/2025, có hiệu lực từ 1/3/2026, tạo cơ sở pháp lý riêng cho hoạt động AI tại Việt Nam. Nhưng luật và nguyên tắc chỉ là một phần. Một hệ thống AI muốn công bằng cần được kiểm tra ngay từ đầu: dữ liệu có đại diện không, tiêu chí nào được sử dụng, nhóm nào có nguy cơ chịu tác động bất lợi, kết quả có khác biệt đáng kể giữa nam và nữ hay không, và người bị ảnh hưởng có cơ chế yêu cầu xem xét lại hay không.
AI không phải tấm gương hoàn hảo phản chiếu xã hội. Nó là một hệ thống do con người tạo ra, được huấn luyện bằng dữ liệu do con người lựa chọn và được triển khai trong những bối cảnh xã hội cụ thể.
Vì thế, câu hỏi “AI có định kiến giới không?” cần được đặt thành một chuỗi câu hỏi cụ thể hơn: Dữ liệu được tạo ra từ đâu? Ai được đại diện? Ai bị bỏ sót? Ai thiết kế thuật toán? Ai kiểm tra kết quả? Và ai có quyền yêu cầu hệ thống sửa sai?
UN Women khuyến nghị đưa đánh giá giới vào quá trình thiết kế AI, bảo đảm dữ liệu đại diện cho những trải nghiệm đa dạng và xây dựng các nhóm phát triển công nghệ đa dạng hơn.
Với Việt Nam, điều đó có nghĩa là câu chuyện bình đẳng giới trong AI không chỉ là đào tạo thêm phụ nữ sử dụng công cụ AI. Quan trọng hơn, phụ nữ cần hiện diện trong nghiên cứu, kỹ thuật, thiết kế dữ liệu, kiểm thử, quản trị và hoạch định chính sách AI.



Doanh nhân - diễn giả Lê Hồng Thủy Tiên: Bình đẳng giới bắt đầu từ một cơ hội công bằng
Người trẻ đang nhìn bình đẳng giới theo hai hướng khác nhau
Bình đẳng giới cần trở thành năng lực nghề nghiệp của giáo viên
Bình đẳng giới nơi công sở: Có nội quy, phải có cơ chế bảo vệ người lên tiếng
PGS.TS Lê Thị Phương Mai giảm điện năng cho mạng 5G và 6G
PGS.TS Lê Thị Thu Hà tạo mô hình 3D chi tiết cho đô thị
Cùng chuyên mục
Muốn bình đẳng giới, phải xử lý từ AI: Câu chuyện không đơn giản
Phụ nữ cần làm gì để ảnh cá nhân không trở thành nguyên liệu cho deepfake?
AI trong ứng phó thiên tai và vai trò của phụ nữ ở tuyến đầu
Tinh gọn bộ máy và bài toán giữ cơ hội lãnh đạo cho phụ nữ
AI là cơ hội mới hay một khoảng cách mới với phụ nữ Việt?
Những phụ nữ Việt đang tạo nên tương lai của AI